Kubeflow 하이퍼파라미터 튜닝
하이퍼파라미터 실습 예제를 통해 AutoML 실험을 생성합니다.
- 예상 소요 시간: 10분
- 권장 운영 체제: macOS, Ubuntu
- 사전 준비 사항
- 참고 사항
- Private 네트워크 환경에서는 학습 파일 다운로드가 원활하지 않을 수 있습니다.
시나리오 소개
Kubeflow와 Katib를 활용하여 하이퍼파라미터 튜닝을 수행하기 전에, MNIST 데이터세트와 실습에 필요한 최소 Kubeflow 환경 사양을 준비합니다. 이를 통해, 사용자는 모델의 성능을 향상시키기 위한 최적의 하이퍼파라미터 조합을 구성할 수 있습니다.
주요 내용은 다음과 같습니다.
- 하이퍼파라미터 튜닝을 통한 모델 성능 최적화
- 자동화된 머신러닝 실험을 통한 최적의 하이퍼파라미터 조합 탐색
- MNIST 데이터세트를 사용한 하이퍼파라미터 튜닝 실습
지원 도구
| 도구 | 버전 | 설명 |
|---|---|---|
| Katib | 0.18.0 | - 하이퍼파라미터를 조정해 모델 성능을 향상시킬 수 있는 오픈소스 프로젝트입니다. - 모델 성능 향상을 위한 다양한 하이퍼파라미터 조합 및 테스트할 수 있습니다. |
Katib에 대한 자세한 설명은 Kubeflow > Katib 공식 문서를 확인해 주세요.
시작하기 전에
1. 학습 데이터 준비
이 실습은 MNIST 데이터세트를 사용합니다. 별도의 다운로드 없이 아래의 실습 단계를 따르면 자동으로 데이터세트를 받을 수 있습니다.
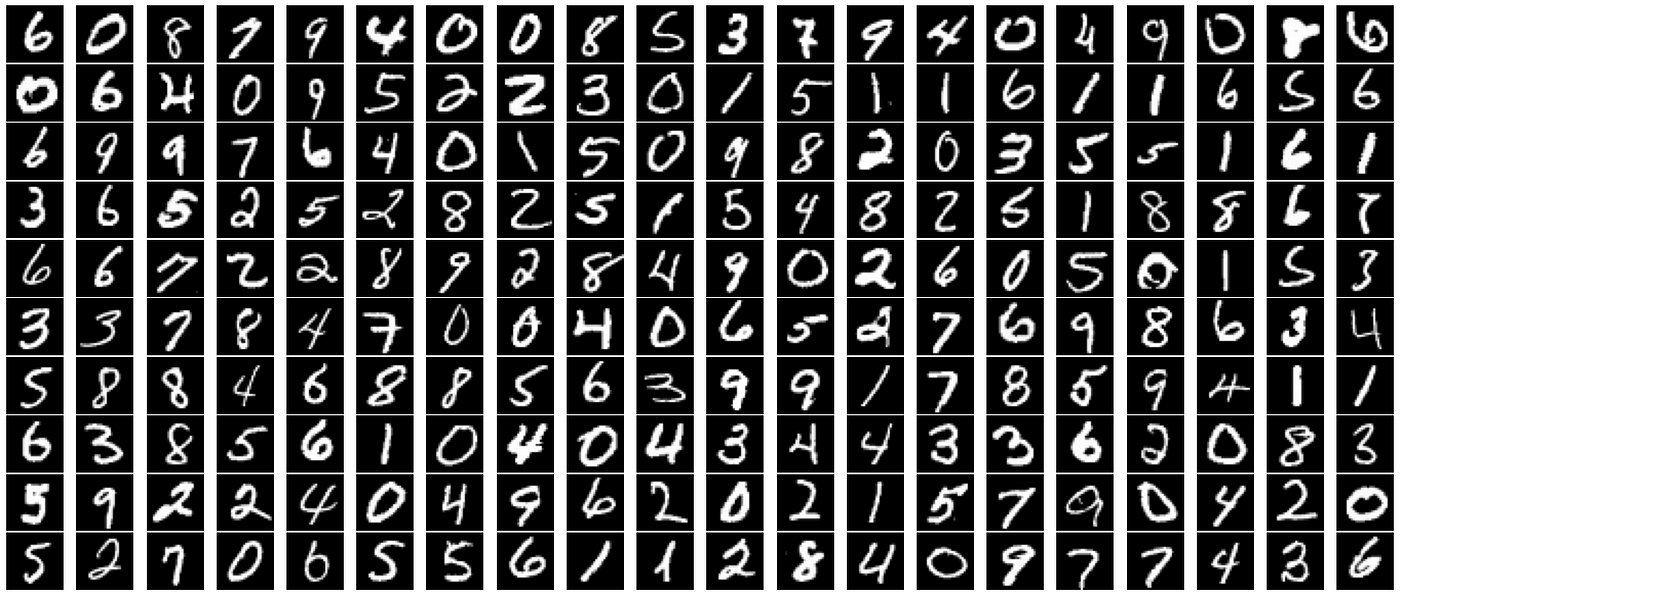 MNIST 이미지 데이터세트
MNIST 데이터세트는 0부터 9까지 숫자의 손글씨 이미지를 모은 데이터세트로, 컴퓨터 비전 분야에서 널리 사용됩니다. 총 70,000개의 28x28 픽셀 회색조 이미지로 구성됩니다.
2. Kubeflow 환경 준비
Kubeflow에서 Katib을 사용하기 전에, 실습에 적합한 MIG 설정과 GPU 노드 풀 사양을 확인하세요. Kubeflow 환경이 준비되지 않았다면, Kubeflow를 이용한 Jupyter Notebook 환경 구성 문서를 참고하여 GPU 파이프라인 노드 풀이 설정된 Kubeflow 환경을 생성하세요.
필요 최소 사양
- MIG 설정 최소 사양 : 1g.10gb 인스턴스 3대 이상
- GPU 파이프라인 노드 풀 필수
- 노드 풀 크기: 100GB 이상
시작하기
Katib를 사용한 MNIST 데이터세트에 대한 하이퍼파라미터 튜닝 과정의 구체적인 단계는 다음과 같습니다.
Step 1. 실습 예제로 새로운 실험 생성
-
Kubeflow 대시보드에 접속합니다.
-
좌측에 위치한 Experiments (AutoML) 탭을 선택합니다.
-
우측 상단에 위치한 [NEW EXPERIMENT] 버튼을 클릭합니다.
-
Create an Experiment 화면에서 [Edit and submit YAML]을 클릭한 뒤 아래 YAML 코드 예제를 복사하여 붙여넣고 [CREATE] 버튼을 클릭합니다.
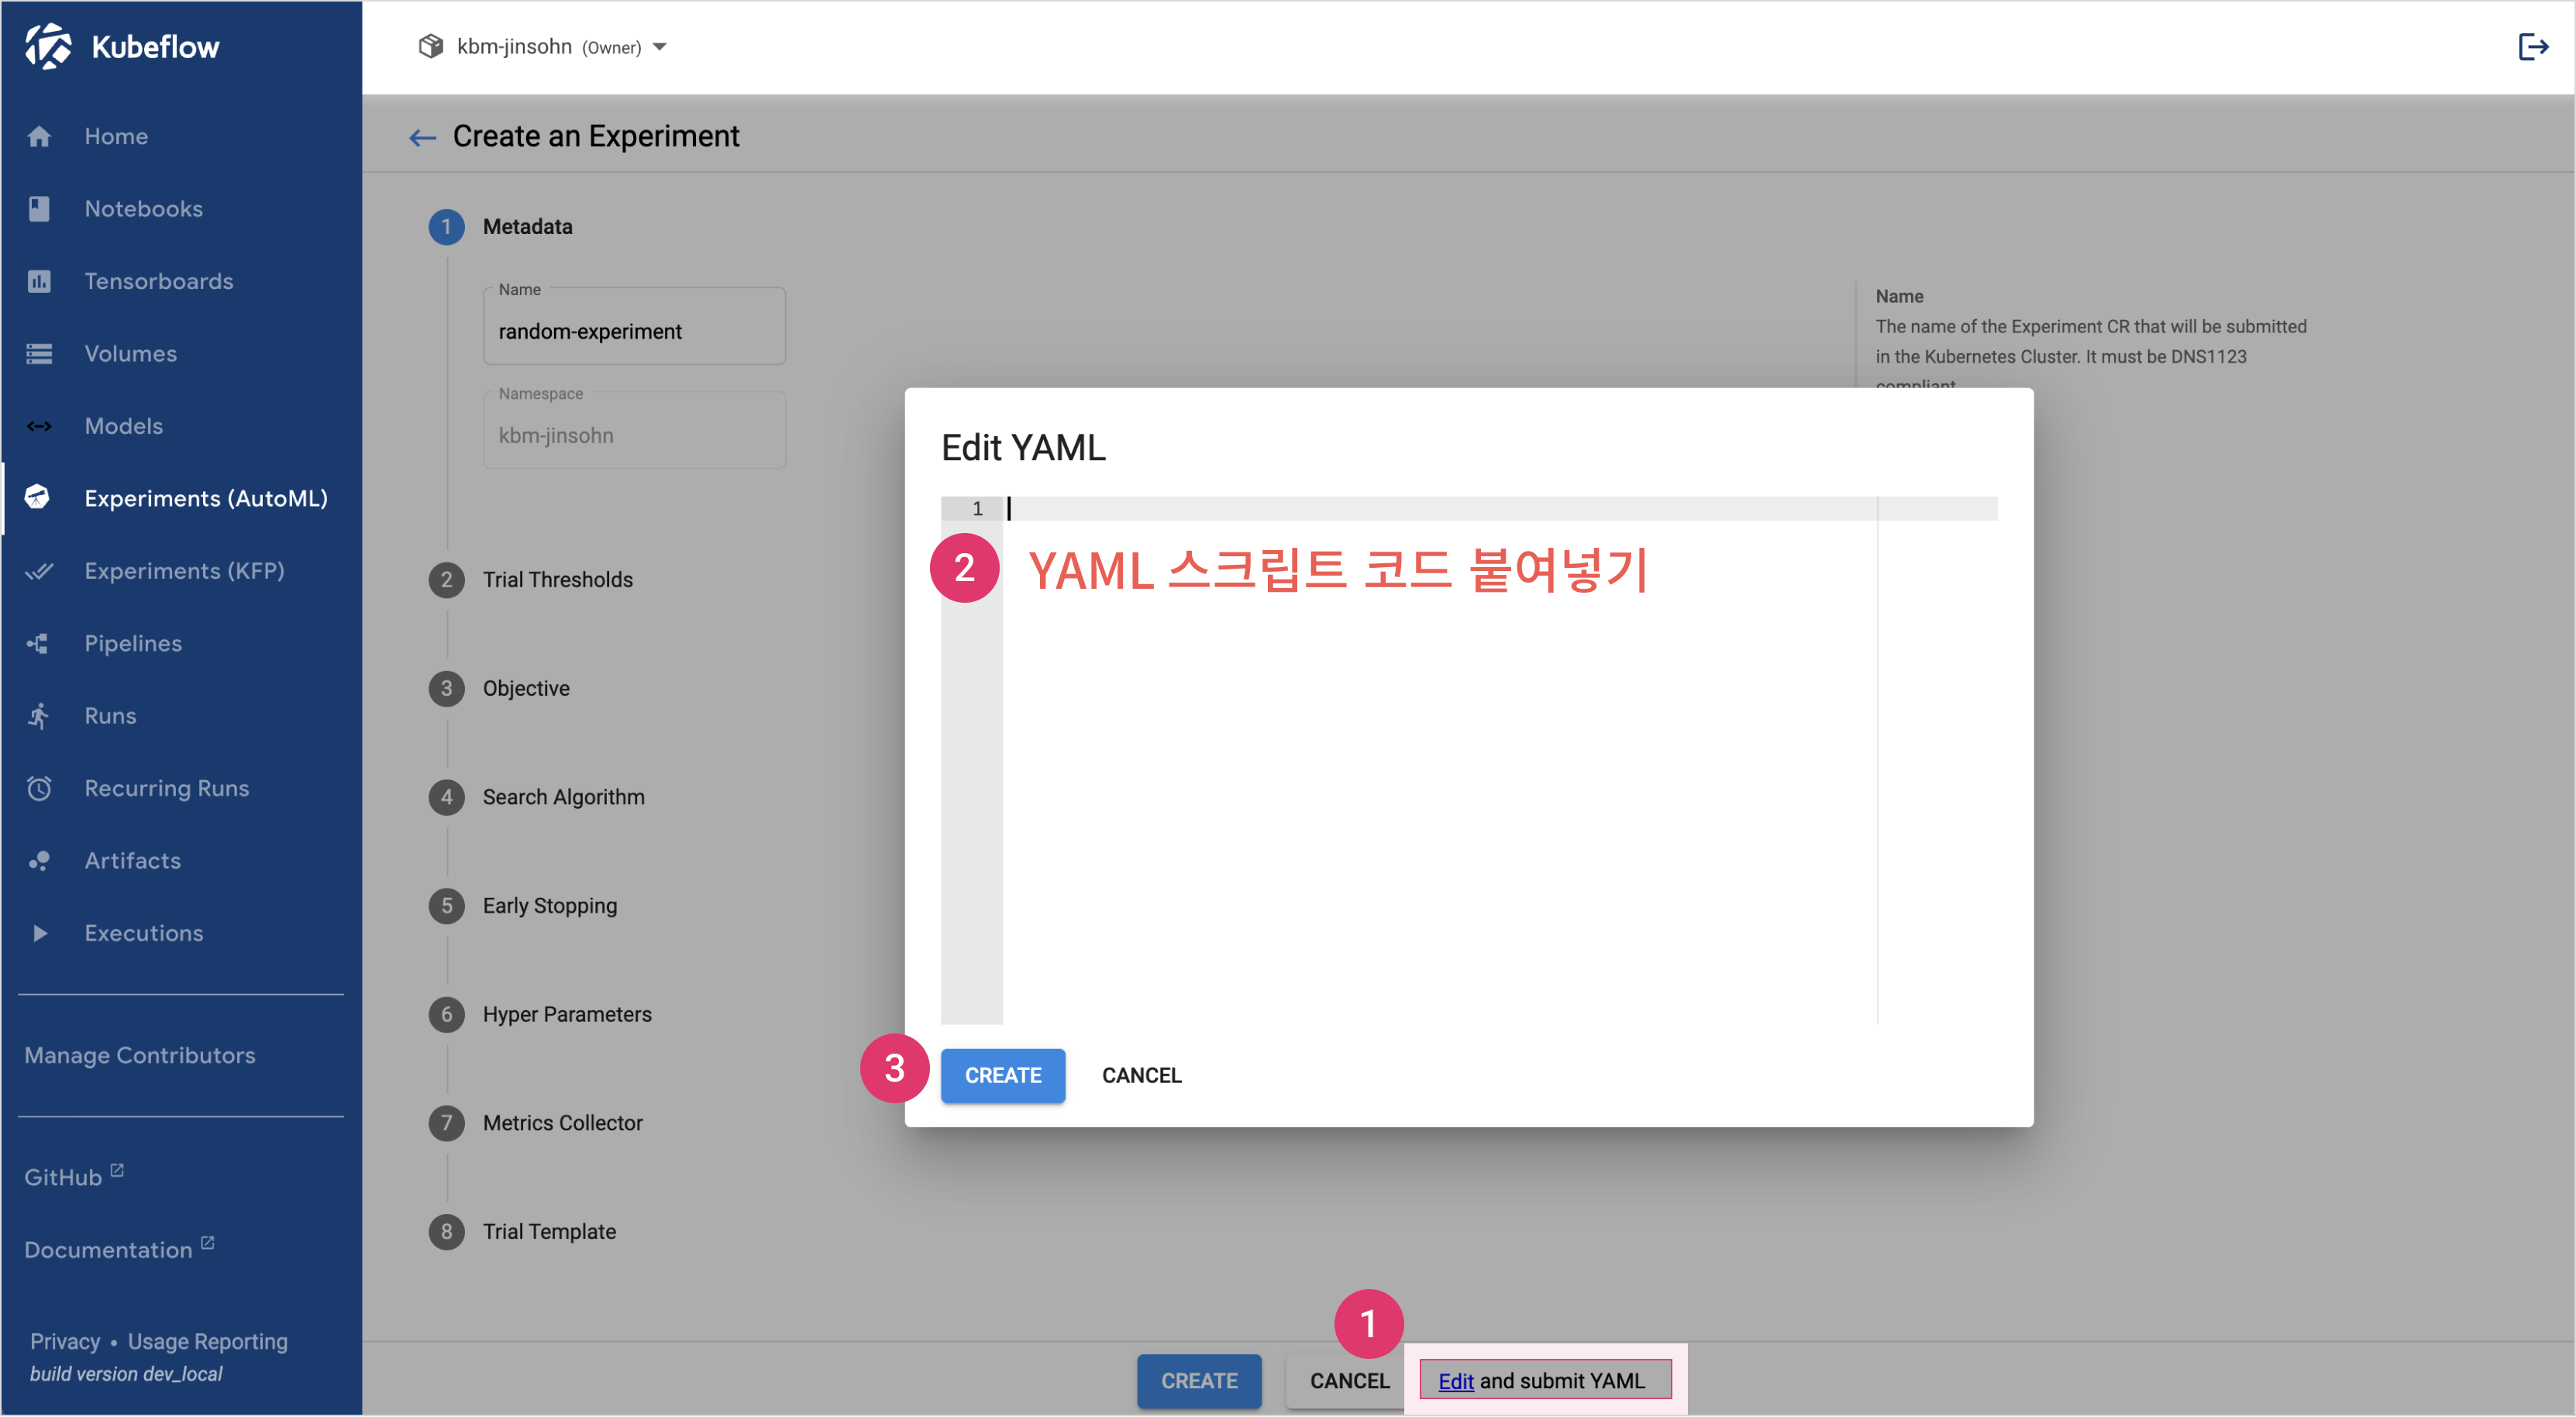 YAML 스크립트 코드 예제 삽입실습 예제. YAML 스크립트 코드 예제
apiVersion: kubeflow.org/v1beta1
kind: Experiment
metadata:
  namespace: kubeflow
  name: test-automl2
spec:
  objective:
    type: maximize
    goal: 0.99
    objectiveMetricName: accuracy
    additionalMetricNames:
      - loss
  metricsCollectorSpec:
    source:
      filter:
        metricsFormat:
          - "{metricName: ([\\w|-]+), metricValue: ((-?\\d+)(\\.\\d+)?)}"
      fileSystemPath:
        path: "/katib/mnist.log"
        kind: File
    collector:
      kind: File
  algorithm:
    algorithmName: random
  parallelTrialCount: 3
  maxTrialCount: 12
  maxFailedTrialCount: 3
  parameters:
    - name: lr
      parameterType: double
      feasibleSpace:
        min: "0.01"
        max: "0.03"
    - name: momentum
      parameterType: double
      feasibleSpace:
        min: "0.3"
        max: "0.7"
  trialTemplate:
    retain: true
    primaryContainerName: training-container
    trialParameters:
      - name: learningRate
        description: Learning rate for the training model
        reference: lr
      - name: momentum
        description: Momentum for the training model
        reference: momentum
    trialSpec:
      apiVersion: batch/v1
      kind: Job
      spec:
        template:
          metadata:
            annotations:
              sidecar.istio.io/inject: 'false'
          spec:
            containers:
              - name: training-container
                image: mlops.kr-central-2.kcr.dev/kc-kubeflow-registry/katib-pytorch-mnist-gpu:v0.18.0.kbm.1a
                command:
                  - "python3"
                  - "/opt/pytorch-mnist/mnist.py"
                  - "--epochs=1"
                  - "--log-path=/katib/mnist.log"
                  - "--lr=${trialParameters.learningRate}"
                  - "--momentum=${trialParameters.momentum}"
                resources:
                  requests:
                    cpu: '1'
                    memory: 2Gi
                  limits:
                    nvidia.com/mig-1g.10gb: 1
            restartPolicy: Never
            affinity:
              nodeAffinity:
                requiredDuringSchedulingIgnoredDuringExecution:
                  nodeSelectorTerms:
                    - matchExpressions:
                        - key: kakaoi.io/kke-nodepool
                          operator: In
                          values:
                            - ${GPU_PIPELINE_NODEPOOL_NAME}
환경변수 설명 GPU_PIPELINE_NODEPOOL_NAME🖌︎ 사용자의 GPU 파이프라인 노드 풀 이름 기입 ex. "gpu-node" 위 예제 YAML 파일은 Katib 실험의 구성을 정의합니다. 이 파일에는 실험의 목적, 최적화할 메트릭, 사용할 알고리즘, 하이퍼파라미터의 검색 범위 등이 포함됩니다.
Step 2. 생성한 실습 실험 확인
-
실험 실행 후, Kubeflow 대시보드에서 Experiments (AutoML) 탭으로 이동하여 실험 결과를 확인할 수 있습니다.
-
실험이 성공적으로 실행었다면, 해당 실험을 클릭하여 자세한 정보와 함께 최적의 하이퍼파라미터 값을 볼 수 있습니다.
안내Katib에 대한 자세한 설명은 Kubeflow > Katib 공식 문서를 확인해 주세요.